Grai · Clasament
Fiecare cifră cu eșantionul, geometria și intervalul de încredere alături. Inclusiv cele care nu ne avantajează.
Măsurat înseamnă că a rulat pe hardware-ul nostru și cifra vine din rulare. Declarat înseamnă că e luată de pe pagina furnizorului și n-am putut-o verifica — sunt modele închise, în cloud. Cele două nu se amestecă niciodată în aceeași coloană fără etichetă.
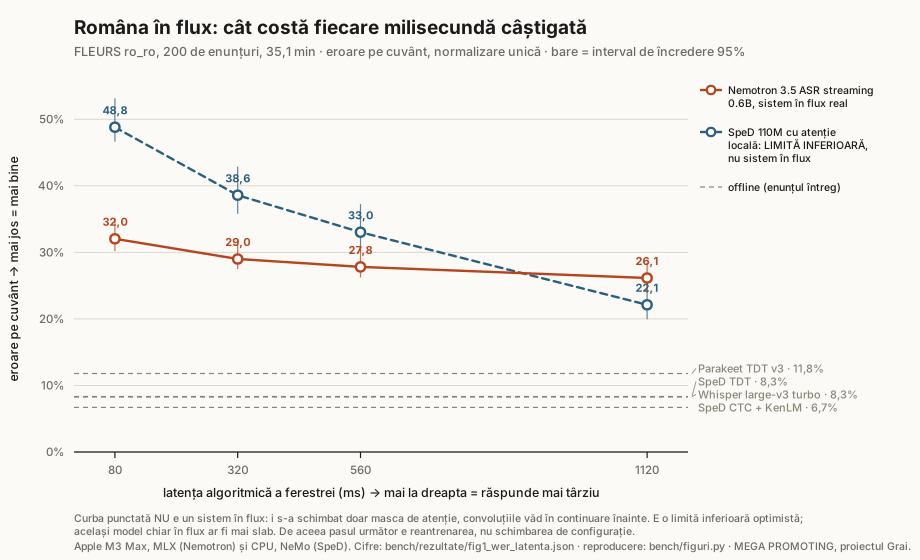
Model: Nemotron 3.5 ASR streaming, 0,6 miliarde de parametri. Eșantion: 200 de enunțuri per limbă din setul de test, aleator uniform, sămânța 20260831. Decodare pe drumul din producție — cache-aware, în flux — nu decodare offline pe fișier întreg. Hardware: Mac M3 Max, recunoașterea prin MLX pe GPU-ul integrat, fără placă dedicată.
Normalizarea textului reparată la 5 septembrie 2026 (grupuri de mii, ore): 26,31% → 26,15% pe română, 9,30% → 9,15% pe rusă. Aceleași transcrieri, rescorate.
| Fereastră | Noi, normalizat | IC 95% | Noi, brut | NVIDIA, fișa | Viteză (RTFx) |
|---|---|---|---|---|---|
| 80 ms | 32,03% | 30,18–35,12 | 33,95% | 31,52% | 1,51× |
| 320 ms | 29,01% | 27,50–32,04 | 31,05% | 29,04% | 3,6× |
| 560 ms | 27,81% | 26,22–30,64 | 29,74% | 27,77% | 6,0× |
| 1120 ms — implicitul nostru | 26,15% | 23,89–28,42 | 27,94% | 25,90% | 13,8× |
| 1120 ms, autodetecție de limbă | 27,71% | 25,57–30,77 | 29,64% | — | 14,1× |
Patru geometrii independente, toate cu cifra din fișa NVIDIA în intervalul nostru de încredere. Cifra noastră nu e un test stricat — e comportamentul cunoscut al modelului, coerent cu fișa producătorului. La 80 ms modelul abia ține pasul cu timpul real (1,51×), deci două sesiuni simultane n-ar mai încăpea pe mașină. Modelul a fost antrenat puțin pe română: fișa NVIDIA o pune în treapta «broad-coverage», a doua din trei, iar FLEURS e declarat în datele lui de antrenare. Cifra noastră e coerentă cu fișa, dar poate fi optimistă; o verificăm cu o probă de memorare.
Autodetecția limbii costă +1,6 puncte (27,71% față de 26,15%; diferența în perechi, pe aceleași enunțuri: +1,58 puncte, IC 95% +0,77…+2,49). De aceea ținem limba fixată oriunde se poate deduce înainte de prima tură; autodetecția rămâne rezervă.
| Fereastră | Noi, normalizat | IC 95% | Noi, brut | NVIDIA, fișa |
|---|---|---|---|---|
| 320 ms | 10,72% | 9,45–12,10 | 14,10% | 9,87% |
| 1120 ms — implicit | 9,15% | 8,08–10,80 | 12,37% | 9,17% |
Româna e de 2,9× mai proastă decât rusa în același model, pe același hardware, în aceeași rulare. Nu e o impresie preluată din fișa cuiva. Agentul nostru bilingv nu are două limbi egale; are o limbă bună și una slabă. Aceeași rezervă de memorare se aplică și la rusă.
Coloana „cum" e partea care face tabelul citibil. Un model care primește fișierul întreg, offline, într-un centru de date, nu rezolvă aceeași problemă ca unul care scoate text în timp ce omul încă vorbește, pe un Mac de birou.
| Sistem | WER FLEURS ro | Cum | Sursa |
|---|---|---|---|
| ElevenLabs Scribe v1 | 3,0% | cloud, lot | declarat · pagina ElevenLabs, altă normalizare |
| Gemini Flash 2 | 3,9% | cloud | declarat · comparația ElevenLabs, altă normalizare |
| Speechmatics Enhanced | 5,28% | cloud și on-prem, în flux | declarat · pagina Speechmatics, altă normalizare |
| Whisper large-v3 | 8,24% | offline, fișier întreg, 1,5 miliarde | declarat · arXiv 2509.14128, Tab. 11, altă normalizare |
| Amazon Transcribe | 8,94% | cloud | declarat · comparația Speechmatics, altă normalizare |
| Google Chirp 2 | 10,91% | cloud | declarat · comparația Speechmatics, altă normalizare |
| Whisper large-v3 | 12,31% / 13,0% | offline, fișier întreg, 1,5 miliarde | declarat · Speechmatics / ElevenLabs, altă normalizare |
| Microsoft Azure Speech | 13,33% | cloud | declarat · comparația Speechmatics, altă normalizare |
| Grai — română | 26,15% | local, în flux, 0,6 miliarde, GPU integrat | măsurat |
| Deepgram Nova-2 | 33,89% / 35,4% | cloud | declarat · Speechmatics / ElevenLabs, altă normalizare |
| Grai — rusă · altă limbă | 9,15% (FLEURS ru) | local, în flux, GPU integrat | măsurat · nu intră în clasamentul român |
Măsurat de noi, cu aceeași normalizare ca Grai. Offline: modelul primește enunțul întreg, nu scoate text în timp ce omul vorbește — deci nu se poate pune în locul recunoașterii în flux.
| Sistem, offline | WER normalizat | IC 95% | Unde a rulat |
|---|---|---|---|
| SpeD 110M (UPB, Apache), CTC + KenLM | 6,70% | 5,51–8,01 | local, procesor |
| Whisper large-v3 turbo | 8,26% | 7,20–9,85 | local, MLX |
| SpeD 110M, TDT fără model de limbă | 8,34% | 7,19–10,17 | local, procesor |
| Parakeet TDT 0.6B v3 | 11,79% | 10,45–13,66 | local |
| Grai — română, în flux, 1120 ms | 26,15% | 23,89–28,42 | local, MLX, GPU integrat |
Cine ne bate pe română, pe mașina noastră, e un model românesc deschis, offline. Diferența de ~19 puncte e taxa de a scoate text în flux; de aceea următorul pas e distilarea lui într-un model mic care merge în flux, nu reglajul lui Nemotron.
Două pagini de furnizor publică cifre pentru aceleași două modele terțe, și nu coincid: Whisper large-v3 apare ca 12,31% la unul și 13,0% la altul; Deepgram Nova-2 ca 33,89% și 35,4%. Adică între două „FLEURS română" publicate există 0,7–1,5 puncte de diferență doar din partiție și normalizare. O lucrare din 2025 (arXiv 2509.14128) dă pentru același Whisper large-v3 8,24% — aceeași denumire de model, trei cifre în trei surse.
Marja aia contează când compari 3,0% cu 5,28%. Nu contează deloc când compari oricare din ele cu 26,15%. Poziția onestă: la acuratețe pe română, în flux, pierdem cu un factor de 5–9×.
Un singur furnizor din listă oferă și on-prem cu română în flux — deci e singurul care ne atacă direct argumentul. Contra lui, argumentul rămâne costul și controlul, nu acuratețea.
Împărțind cele 200 de enunțuri după prezența cifrelor în referință:
| Enunțuri | n | WER normalizat | WER brut | Ce spune |
|---|---|---|---|---|
| fără cifre | 163 | 25,08% | 25,43% | normalizarea aproape nu contează |
| cu cifre | 37 | 29,65% | 36,94% | normalizarea ascunde 7,3 puncte |
Un enunț cu cifre e cu 4,6 puncte mai prost normalizat și cu 11,5 puncte mai prost brut. Exemple reale din rulare:
| Referință | Ce a ieșit |
|---|---|
| din 1988 urnele de vot… | Denomin ustie xopt, urnele de votre… |
| în 1537 paraguay… | în o mie cinu ste și șapte, Paraguay… |
| pușca sa m16 | ca să M Shaișpe |
| cele 25 de postere dunlap | Cele douăze și inci de postere Danop |
Orice normalizare care scrie numerele în litere înainte de scorare ne face să arătăm mai bine decât suntem la telefon. De aceea raportăm și brut. Pentru un agent care ia numere de telefon, ore, prețuri și date, partea cea mai importantă a limbii e și cea mai stricată. De ce contează normalizarea →
Două rulări diferite, cu două întrebări diferite. Nu se adună între ele.
n=29 replici, p50, măsurat la client, de la ultimul eșantion de vorbire al omului.
n=17 replici, p50, gpt-5.4-nano. Fiecare segment are două capete observate, nu calculate — suma celor șase segmente dă totalul cu abatere sub o jumătate de milisecundă.
Cei 92 ms de recunoaștere sunt golirea după ce omul tace; textul parțial în timpul vorbirii vine cu întârzierea ferestrei, ~1,1 s la 1120 ms. Singura piesă care nu rulează local e și 69% din întârziere.
Reper: HumDial, ICASSP 2026, raportează 1,26 s pentru câștigător, după definiția concursului. E o mărime diferită de 1235 ms sau 2667 ms de mai sus; nu se scad una din alta. Ce arată reperul: acolo unde full-duplexul se măsoară cu adevărat, cifrele sunt de ordinul secundei, nu 300 ms.
Măsurat pe conversații umane reale din CANDOR, în engleză: 80 de clipuri, 98 de pauze, reluare offline. Metrica e TOR — proporția pauzelor din mijlocul frazei în care sistemul a decis greșit că omul a terminat. Cu prag fix de 0,6 s, 69,4%; pe intonație, la 560 ms așteptare, 52,0% — cât îi trebuie cronometrului 820 ms ca să atingă. Câștigul nu vine din a decide mai rar: decizia pe prozodie ia mai multe decizii decât pragul fix, și tot greșește mai puțin. Repere publice: 9,9% tăieri false la 300 ms și 4,5% la 600 ms, la LiveKit v1 — declarat, engleză, altă metrică (rata tăierilor false, nu TOR), deci nu se compară direct.
Studiul explică cele șase capcane de metodologie care fac tabelele publicate incomparabile — cu exemple din propriile noastre greșeli.